通讯作者:张牧星
通讯单位:南京理工大学
DOI:10.1016/j.ces.2026.124750

《2025年我司用户发表的液流电池论文合集》
1.机器学习模型的预测性能
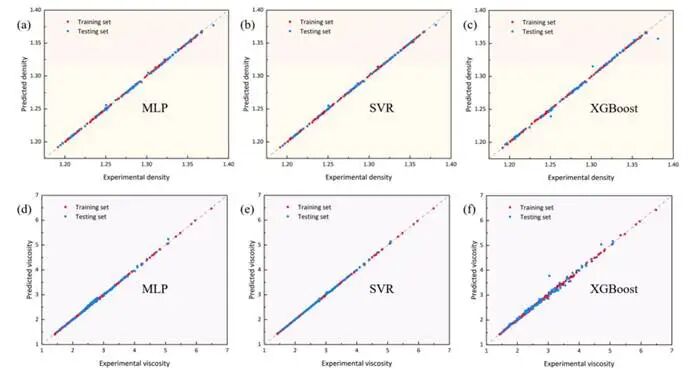
图1.使用(a)MLP模型、(b)SVR模型和(c)XGBoost模型计算的密度值(g/cm³)与预测值对比;以及使用(d)MLP模型、(e)SVR模型和(f)XGBoost模型计算的粘度值(mm²/s)与预测值对比
在密度方面,预测值沿对角线紧密分布于约1.2–1.4g/cm³的实验范围内,表明三种模型均能高精度地预测密度值。在测试集中,SVR和MLP表现出相当的预测性能,RMSE分别为0.0008和0.0012g/cm³;相比之下,XGBoost在实验密度值约为1.25、1.30和1.37g/cm³处出现了三个明显偏离点。相应的测试集R2,SVR为0.9997,MLP为0.9994,XGBoost为0.9949。
关于粘度,SVR模型在整个粘度范围内与实验值最为吻合。MLP模型也能给出准确的预测结果。相比之下,XGBoost模型的测试集预测值分布范围较广,表明预测准确性相对较低,与SVR、MLP和XGBoost模型的测试集R²分别为0.9996、0.9980和0.9818的结果一致。结果表明所有模型都可以提供高精度的预测,其中SVR显示了最佳的整体性能。
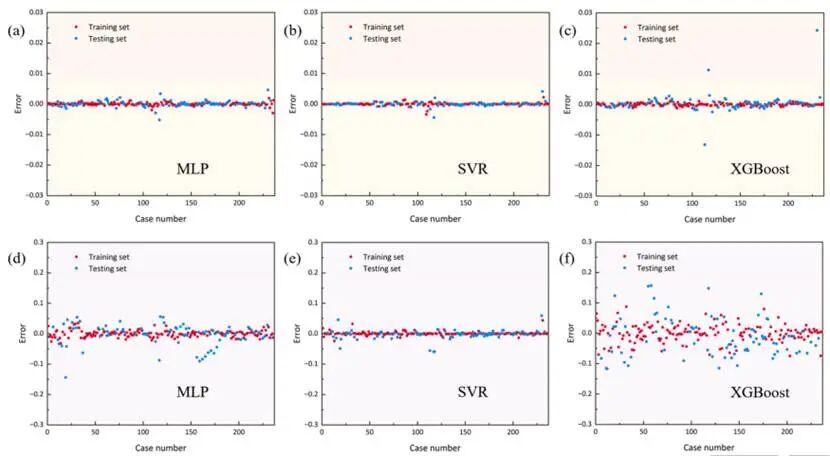
图2.密度(g/cm³)的带符号预测误差采用(a)MLP模型、(b)SVR模型、(c)XGBoost模型;粘度(mm²/s)的带符号预测误差则采用(d)MLP模型、(e)SVR模型、(f)XGBoost模型
对于密度参数,所有模型在训练集和测试集中的残差均紧密分布于零附近,大部分误差落在±0.005g/cm³范围内。MLP和SVR模型的残差分布尤为集中,在整个数据集中未表现出明显的系统性偏差。相比之下,XGBoost模型的残差分布略宽,并在测试集中出现更多偏差。对于粘度参数,各模型之间的差异更为明显:MLP模型的测试集残差大多在±0.05mm²/s范围内,但部分测试样本的偏差接近−0.10至−0.15mm²/s;而SVR模型的残差范围最窄,大多数测试集残差值约为±0.03mm²/s。与之相反,XGBoost模型的残差分布明显宽于MLP和SVR模型,部分测试集残差值超过0.16mm²/s,表明鲁棒性弱于MLP和SVR模型。
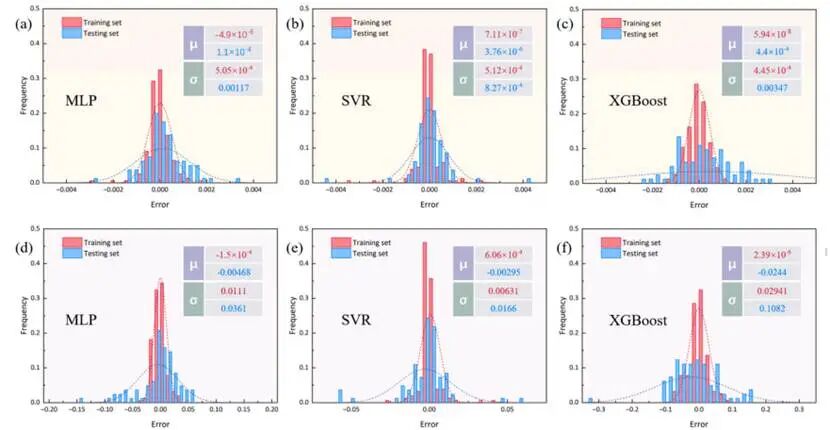
图3.采用(a)MLP模型、(b)SVR模型、(c)XGBoost模型分析电解液密度(g/cm3)的符号误差直方图及正态拟合曲线;以及采用(d)MLP模型、(e)SVR模型、(f)XGBoost模型分析黏度(mm²/s)的符号误差直方图及正态拟合曲线
对于密度数据,三种模型在训练集上的残差分布均集中于接近零的区域,表明其预测误差较小。在测试集上,MLP的标准差(σ)为1.17×10⁻³g/cm3,SVR为8.27×10−4g/cm3,XGBoost为3.47×10⁻³ g/cm³;此外,XGBoost在训练集上的绝对均值残差(μ)为5.94×10⁻⁸g/cm³,小于MLP(4.9×10−6g/cm3)和SVR(7.11×10⁻⁷g/cm³),表明其对训练数据的拟合中系统性偏差可忽略不计。然而,在测试集上,SVR的μ和σ均小于MLP和XGBoost,表明其对未见数据具有更好的泛化性能。对于黏度数据,测试集上的σ分别为:MLP为0.0361mm²/s、SVR为0.0166 mm²/s、XGBoost为0.1082mm²/s;相应的μ值则均接近零,分别为−0.00468mm²/s、−0.00295mm²/s和−0.0244mm²/s。在这三种模型中,SVR再次呈现出最窄且中心最集中的残差分布,其次是MLP;而XGBoost则显示出最宽的分布范围,表明对未见数据的预测性能较弱。
2.模型评估的稳健性分析
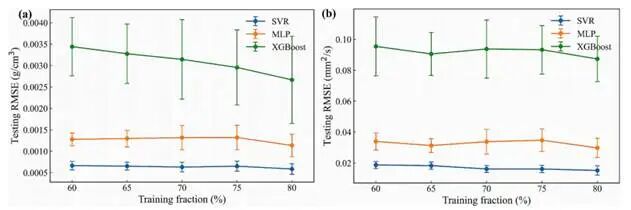
图4. 训练集比例对测试RMSE的影响:(a)密度;(b)黏度
三种模型的测试RMSE曲线随训练比例增加而变化,表明预测性能并未受特定训练/测试比例的显著影响。在密度预测方面,XGBoost的测试RMSE随训练比例增加略有下降,而SVR和MLP则基本保持稳定;在粘度预测方面,三种模型在不同训练比例下均呈现相对稳定的趋势。
4.关于分子水平描述符贡献度的消融研究
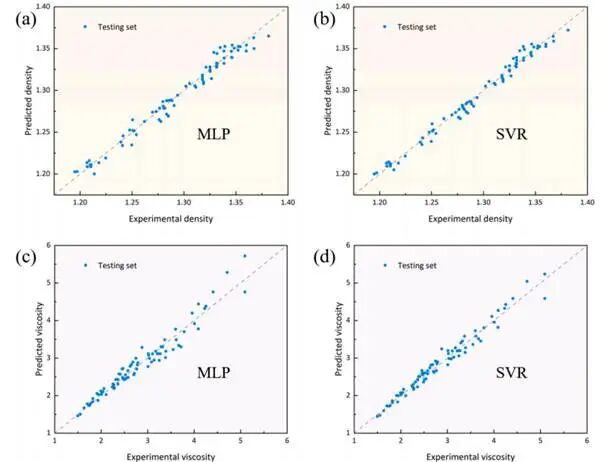
图5.使用(a)MLP模型和(b)SVR模型计算的密度值(g/cm³)与预测值对比;以及使用(c)MLP模型和(d)SVR模型计算的粘度值(mm²/s)与预测值对比
对于密度,测试集R²在MLP中降至0.9764,在SVR中降至0.9871;而RMSE则分别升至0.0075和0.0055。粘度的性能下降更为明显,测试集R²在MLP中降至0.9466,在SVR中降至0.9710;RMSE则分别升至0.1877和0.1390。与包含物理驱动描述符的模型相比,仅基于状态参数的预测显示,密度和粘度与对角线的偏差更大。结果表明仅凭状态参数不足以完全反映电解质特性的变化。
5.描述符分析
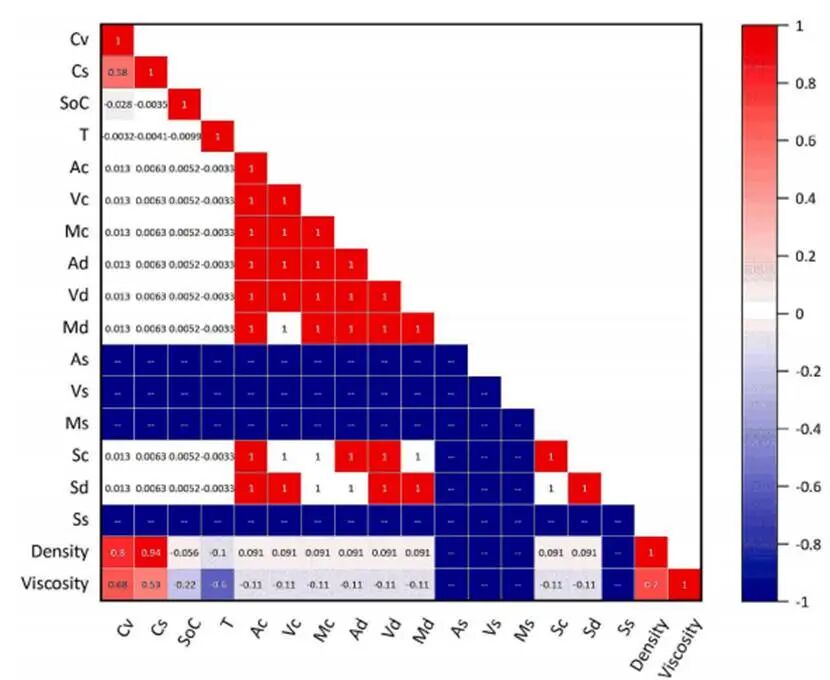
图6.输入描述符的相关矩阵
可以看出,实验状态参数与其它描述符之间不存在显著的线性关联,表明这些特征并非线性冗余,并可能有助于构建更稳健的机器学习模型。还可以看出,密度与钒浓度(r=0.80)及硫酸浓度(r=0.94)呈正相关,表明密度受Cv和Cs变化的强烈影响。相比之下,黏度与Cv(r=0.68)和Cs(r=0.53)呈正相关,但与温度(r=−0.60)及SOC(r=−0.22)呈负相关,表明黏度不仅受浓度影响,还受温度依赖的液体摩擦以及与电化学状态相关的元素形态和溶剂化结构变化的影响。此外,密度和黏度均与若干COSMO-RS描述符呈现显著相关性,进一步佐证了分子层面信息对预测电解质性质的重要性。
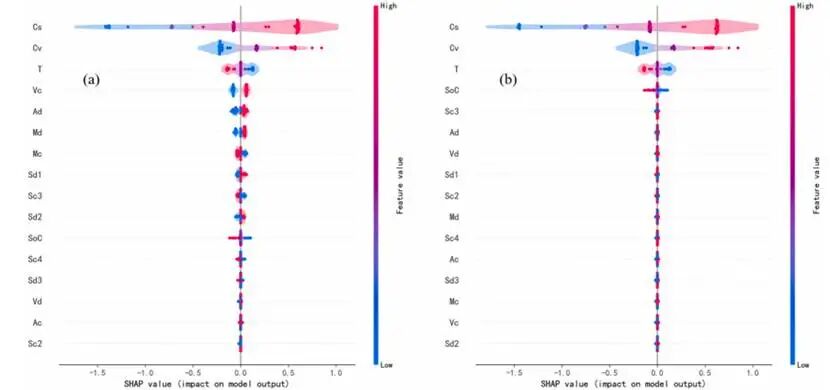
图7.测试数据集中电解质密度预测的形状特征重要性:(a)MLP;(b)SVR
在密度预测方面,Shap分析结果表明Cs、Cv和温度是主要的预测指标,其影响与钒电解质预期的物理化学行为一致。较高的Cs和Cv值主要对应正向的Shap系数,表明增加硫酸和钒浓度会使模型预测值向更高密度方向偏移;相反,较高温度值则倾向于产生负向的Shap贡献,与热膨胀导致液体密度降低的现象相符。SOC对密度预测的贡献较弱且更依赖于模型参数,说明体密度主要受溶质浓度和温度的影响,而非电化学状态的变化。
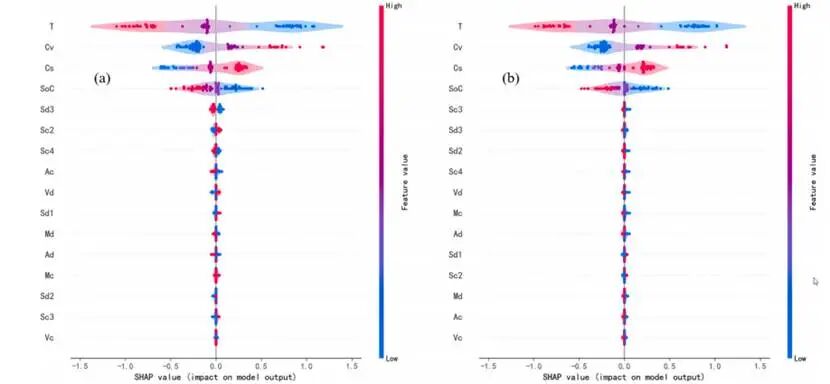
图8.测试数据集中电解质粘度预测的形状特征重要性:(a)MLP;(b)SVR
关于黏度预测,温度的贡献最大,高温样本主要对应于负SHAP,低温样本对应于正SHAP。与物理预期一致:温度升高可增强分子及离子迁移率,从而降低流动阻力;相反,较高的Cv和Cs通常会增大预测黏度,可归因于浓度较高的电解质中更强的离子–离子及离子–溶剂相互作用。SOC对黏度的影响也比对密度的影响更为显著,表明在充放电过程中,钒的价态变化及其伴随的水合/溶剂化结构变化对液体摩擦的影响比对总体密度的影响更为敏感。
6.避免进行高浓度边界验证
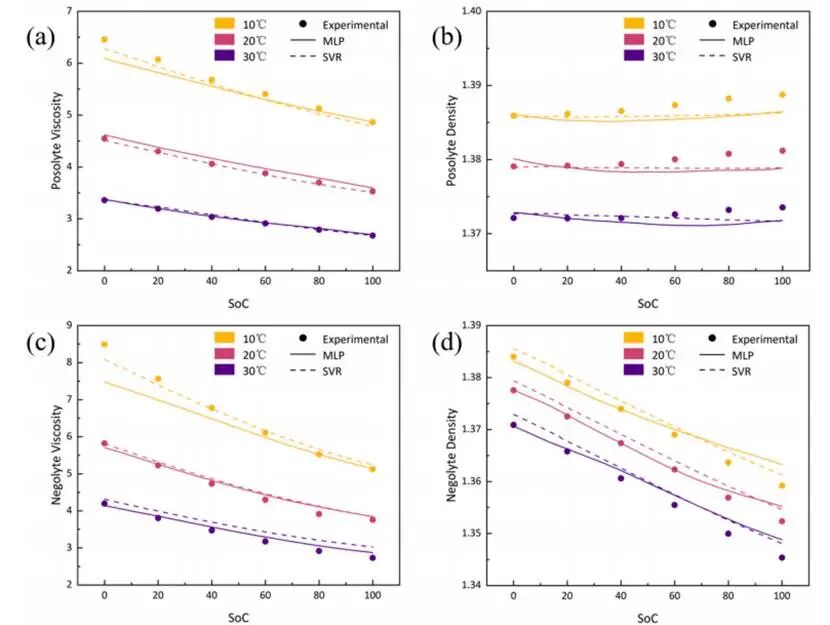
图9.电解质保留数据的预测结果:(a)电解质粘度,(b)电解质密度,(c)非电解质粘度,(d)非电解质密度
本研究开发了一种基于物理原理的机器学习框架,利用COSMO-RS衍生的分子描述符来预测VRFB电解质的密度和黏度。通过将实验状态参数(包括钒和硫酸浓度、温度及荷电状态)与基于物理的分子信息相结合,所得模型实现了较高的预测精度。由此得出以下结论:。
1)所有三种基于物理原理的机器学习模型均能以较高的精度预测密度和黏度值,表明将机器学习应用于VRFB电解质的热物性预测是可行的。其中,SVR模型的整体性能最佳,其在测试集上的R²对于密度和黏度分别为0.9997和0.9996;2)与MLP和SVR相比,XGBoost在当前数据条件下测试性能较弱,且分组间的变异性较大,尤其是在黏度预测方面;3)对包含与不包含物理驱动描述符的模型进行比较,证实了由COSMO-RS衍生的描述符能够提供超越实验状态变量的有用分子级信息;4)保留的高浓度样品为所开发模型提供了额外的边界验证。对1.83M钒电解液的良好预测性能表明,模型能够准确描述接近所研究体系浓度上限范围内的样品;而对于超出定义适用范围的样品,则需谨慎解读其预测结果。