
第一作者:韩征
通讯作者:纪亚
通讯单位:上海交通大学
DOI:10.1016/j.apenergy.2026.128927
感谢上海交通大学纪亚团队(第一作者:韩征)校稿!

《2025年我司用户发表的液流电池论文合集》
1.数据审查与模型性能分析
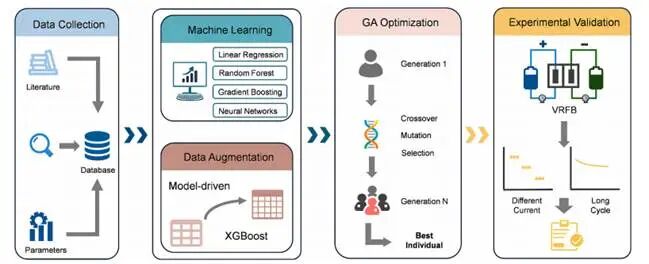
图1.研究方法论示意图:从现有文献中收集数据、机器学习、数据增强、遗传算法优化及实验验证
典型的机器学习优化研究通常包括数据集构建、模型开发及实验验证三个阶段:首先通过系统性地收集关于VRFBs中杂原子掺杂碳电极的已发表数据,构建一个综合性数据库;为克服数据不足的限制,在机器学习模型训练前采用主动学习辅助的数据增强策略;随后对优化后的机器学习模型进行验证。该模型与遗传算法相结合,以高效探索高维参数空间并确定最优电极设计。随后,通过电化学表征和VRFB循环测试,验证了所提出的优化框架的可靠性及实际应用潜力。
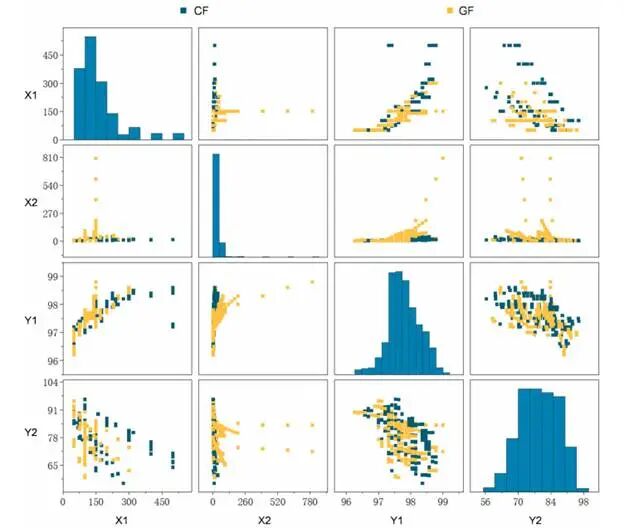
图2.部分原始数据集的配对图与变量分布直方图
分布情况表明电流密度与循环次数分别主要集中于低于200mA cm⁻²及100次循环以下区间,说明所采集数据中大部分来自中低电流密度下的短期运行工况。对于CF与GF两种电极类型,X1均与Y1呈正相关,与Y2呈负相关;而X2与Y1及Y2的关系则完全相反。然而,从散点分布中并未表现出明确的函数关系,表明输入特征与输出响应之间的映射关系本质上具有复杂性,且很可能呈非线性特征。
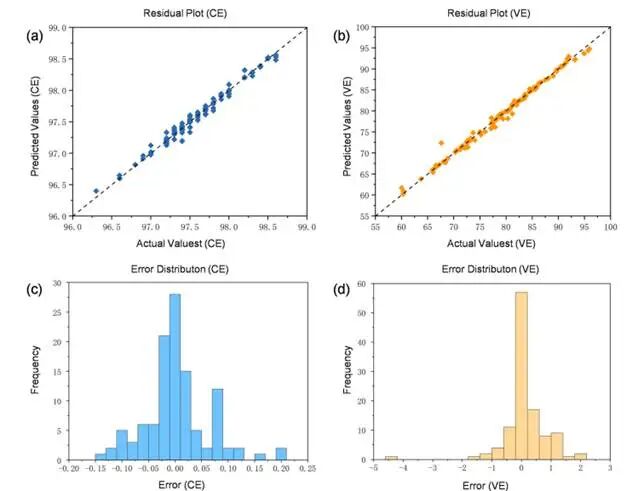
图3.(a)CE与(b)VE的XGBoost模型残差图;(c)CE与(d)VE的XGBoost模型误差分布直方图
XGBoost模型对CE与VE的预测值均与实验数据高度吻合。残差围绕零值呈对称且随机分布,未显现明显系统性偏差或结构性特征。少量较大残差主要出现在采样稀疏区域,尤其是极高电流密度区域。在这些区域,邻近观测值的有限可用性加剧了跨研究变异性影响,从而导致预测不确定性增大。
误差分布直方图显示CE模型预测的总体误差范围略大于VE模型。从分布形态来看两种性能指标的误差分布均近似服从正态分布:高频误差主要集中在零值附近,且未观察到明显的长尾或偏态分布特征。此外,所有较大误差值均处于可接受范围内,表明该模型的预测结果在统计学上具有可靠性。
2.数据增强与模型可解释性
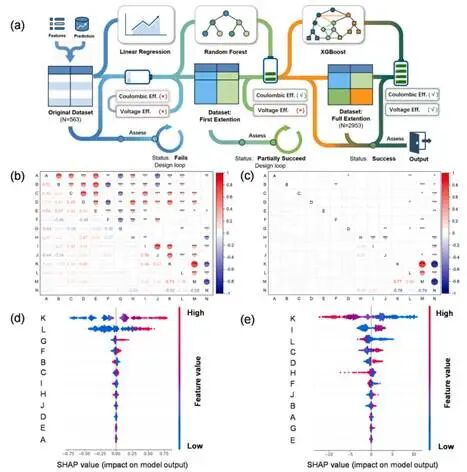
图4.a)本研究数据增强流程的流程图;显示不同参数间皮尔逊相关性的热图:(b)数据增强前,(c)数据增强后(*p≤0.1,**p≤0.05,***p≤0.01)。适用于XGBoost算法的所有特征的Shap值:(d)CE,(e)VE
皮尔逊相关热力图相关性分析表明在数据增强前,VE与电流密度及氧含量均呈现强相关性。然而,VE与循环次数之间并未呈现显著相关性,可归因于中存在一定比例。针对原始数据集中长循环周期样本的分析表明:由于杂原子掺杂电极在长期循环过程中通常能保持相对稳定的性能,循环次数对VE的线性贡献在统计学上被削弱,从而导致相应的皮尔逊相关系数降低。相比之下,CE与电流密度及循环次数均呈现强相关性。此外,CE与VE之间亦观察到强相关性,可能源于这两个性能指标间的内在耦合效应,即那些提升CE的性能工况或结构因素,往往会在一定程度上对VE产生负面影响。此外,在数据增强前构建的相关性热图中,某些理论上预期无强关联的输入变量(如ID/IG与隔膜类型)却显示出相对较高的相关系数,很可能源于样本量有限,进而引入统计偏差与伪相关性。经过数据增强处理后,上述异常现象均显著减弱。先前在无关变量间观察到的虚假高相关性被显著削弱,而具有理论意义的关联关系仍以相对较高的相关系数得以保留。由此,整体相关性结构变得更加连贯、易于解释,并与既有的电化学理论相契合。研究结果表明数据增强技术可有效提升数据集的代表性,进而增强相关性分析的可靠性与稳健性。
本研究对每个特征计算了Shap值,Shap分析表明电流密度与循环次数是对CE及VE最具影响力的参数:CE随循环次数增加而上升,并逐渐趋近稳定值;而VE则因长期循环导致的性能衰减而显著下降。在中等电解质浓度范围内,H₂SO₄浓度的变化也会对CE产生一定影响,主要源于质子浓度对膜电导率及电化学反应动力学的作用。相比之下,其他结构及表征参数(如ID/IG与杂原子含量)对CE的贡献通常较弱。对于VE而言,除电流密度与循环次数外,N含量、ID/IG及O含量均具有重要影响。此外,硼含量在VE预测中的Shap重要性值较低。结合现有文献,本研究发现表明:相较于氮掺杂,硼掺杂对电极性能的提升作用相对有限。
3.VRFB性能优化
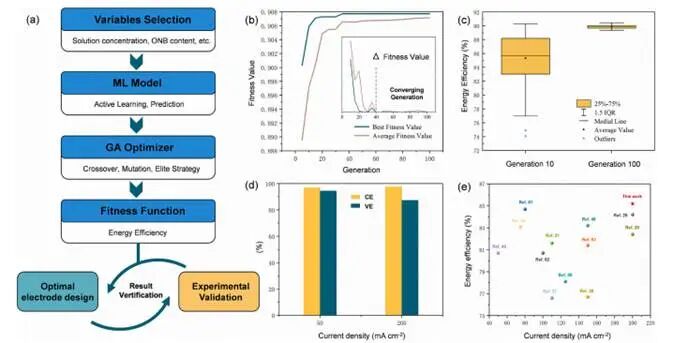
图5.(a)本研究中采用遗传算法结合主动学习进行优化流程的流程图;(b)精英遗传算法适应度值的收敛曲线图;(c)不同进化代际下精英遗传算法种群分布的箱线图对比;(d)优化后电极在不同电流密度下的预测CE与VE;(e)优化后电极的预测EE与现有杂原子掺杂CF及GF电极的预测值对比
作者团队建立了一个预测框架用于根据所选输入参数估算VRFB性能。基于该框架,采用了一种结合主动学习与遗传算法(GA)的混合优化策略,以识别高性能电极及操作条件。结果表明最优适应度值大约在第40代时达到收敛,而平均适应度值在相近阶段也呈现出明显的收敛趋势,并在后续迭代中继续轻微上升,直至第100代趋于稳定。精英遗传算法种群在第10代和第100代时适应度值分布的箱线图表明第10代种群相较于第100代种群表现出显著更高的离散度。具体而言,四分位距(IQR,第25至第75百分位数)明显更大,而由1.5倍IQR定义的总体离散范围也相应扩大。这些特征表明在优化过程的早期阶段,种群表现出显著的性能差异,仍处于搜索过程中的广泛探索阶段。此外,第10代时的中位数及平均适应度值明显低于第100代时的数值,说明大多数个体尚未向高适应度区域演化,整体解决方案质量仍较为有限。超出1.5倍IQR范围的异常值的存在,进一步反映了低性能个体的存在以及初始进化阶段缺乏明确优化方向的情况。相比之下,第100代时的种群分布已展现出明显的收敛特征:IQR值显著降低,整体分布范围收窄,中位线及平均适应度值均向上偏移。此外,未再观察到低值异常值,表明低适应度个体已通过该过程被有效淘汰。结果表明遗传算法能够逐步提升种群质量,并随着世代数的增加实现稳定收敛。
经过100代优化后,模型达到了最佳预测性能,对应的CE为96.7%,VE为94.4%。当电流密度增至200mA cm⁻²时,CE与VE分别调整为97.6%和87.3%,对应的EE为85.2%。基于此优化参数集,在固定其余变量的前提下仅改变电流密度与循环次数,模型预测在电流密度为300mA cm⁻²、循环500次时,EE可达77.4%。进一步评估优化方案的鲁棒性,在预测最优值附近进行了局部扰动分析。结果表明N与B含量处于相对平坦的响应区间,而O含量对预测EE的影响甚微;相比之下,ID/IG在优化描述符中表现出最高的局部敏感性。因此,GA推导出的最优值更宜被解读为鲁棒的高性能区间,而非唯一的理论最大值。此外,优化电极的预测EE仍显著高于既往研究中采用类似O、N、B杂原子修饰的CF与GF基电极的报道值,充分证明该优化参数组合使掺杂电极在VRFB中展现出优异的倍率性能。
4.实验验证与误差分析
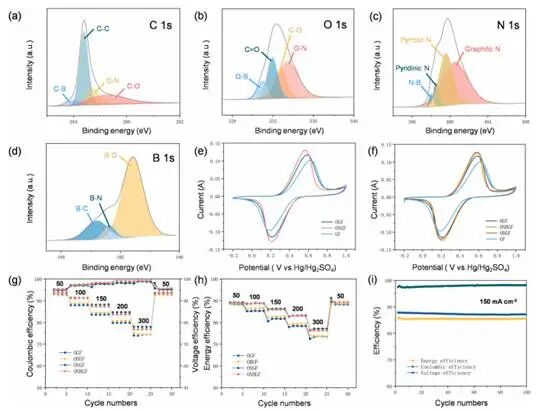
图6.(a)ONBGF的C 1s、(b)O 1s、(c)N 1s及(d)B 1sXPS谱图;(e)GF、OGF与ONGF电极的循环伏安曲线(在0.1M VOSO₄+2.5M H₂SO₄溶液中,扫描速率10mV s⁻¹);(f)GF、OGF、OBGF与ONBGF电极的循环伏安曲线(在0.1M VOSO₄+2.5M H₂SO₄溶液中,扫描速率10mV s⁻¹);(g)OGF电极、ONGF电极、OBGF电极及ONBGF电极在VRFB中的CE曲线、VE曲线及(h)EE曲线;(i)ONBGF电极在150mA cm⁻²下的长期循环性能