第一作者:张佳可
通讯作者:徐谦
通讯单位:江苏大学能源研究院
DOI:10.1016/j.cej.2026.183461
感谢江苏大学徐谦团队供稿!

在“双碳”目标与高比例可再生能源并网的背景下,水系氧化还原液流电池(aqueous redox flow batteries, ARFBs)凭借功率与容量解耦、本征安全、循环寿命长等优势,成为大规模长时储能的重要候选技术。然而,从活性分子筛选、膜/电极/流场等关键部件设计,到电池状态监测与系统管理,ARFBs 研发全链条长期受困于实验试错成本高、多物理场耦合复杂、运行状态难以精准感知等瓶颈。近年来,机器学习(machine learning, ML)凭借其强大的非线性拟合与跨尺度建模能力,正在以前所未有的速度重塑水系液流电池的研究范式。
《2025年我司用户发表的液流电池论文合集》
【论文奖励】2026年8月液流电池论文奖励清单!
【论文奖励】2026年7月液流电池论文奖励清单!
【论文奖励】2026年5~6月液流电池论文奖励清单!
【论文奖励】2026年4月液流电池论文奖励清单!
【论文奖励】2026年3月液流电池论文奖励清单!
【论文奖励】2026年2月液流电池论文奖励清单!
进入21世纪以来,全球经济快速发展带来能源需求的持续攀升,而化石能源的大量消耗又引发了一系列环境问题[1]。在“双碳”目标牵引下,太阳能、风能等可再生能源受到前所未有的关注[2]。然而,风光发电固有的间歇性与波动性给电网安全稳定运行带来了严峻挑战,迫切需要可靠的大规模储能技术在时间与空间上实现能量迁移[3]。在众多储能技术中,氧化还原液流电池因其容量与功率解耦、本征安全、循环寿命长等特点,被认为是长时储能领域最具前景的技术路线之一[4]。与非水系液流电池相比,水系体系以水为介质,电解液成本低廉、安全性高、环境友好,更适合大规模工程化部署。但水系体系自身也面临一系列本征难题:电化学窗口窄、能量密度受限、热力学稳定性不足;在强酸性或强碱性条件下,pH 与电位之间存在强烈耦合;高浓度盐溶液中物理传输与水合效应复杂;水解、聚合、活性物种化学降解等副反应不可避免,往往导致电解液稳定性恶化与容量快速衰减[5]。从研发范式来看,水系液流电池的材料开发已经从早期爱迪生式的实验试错,逐步过渡到基于密度泛函理论(DFT)的高通量计算筛选,标志着研究由经验探索走向微观理论指导[6]。然而,面对广袤的分子化学空间以及 pH-电位耦合、水合效应等复杂问题,高精度物理模型的计算效率已难以满足长时储能材料快速迭代的需求,计算资源瓶颈日益凸显。在此背景下,机器学习作为一种新兴的数据驱动研究范式应运而生。它能够从实验与计算数据中挖掘隐含的复杂非线性关系,突破传统方法的算力约束,并有望贯通从微观材料设计、介观结构优化到宏观系统管理的完整研究链条[7]。
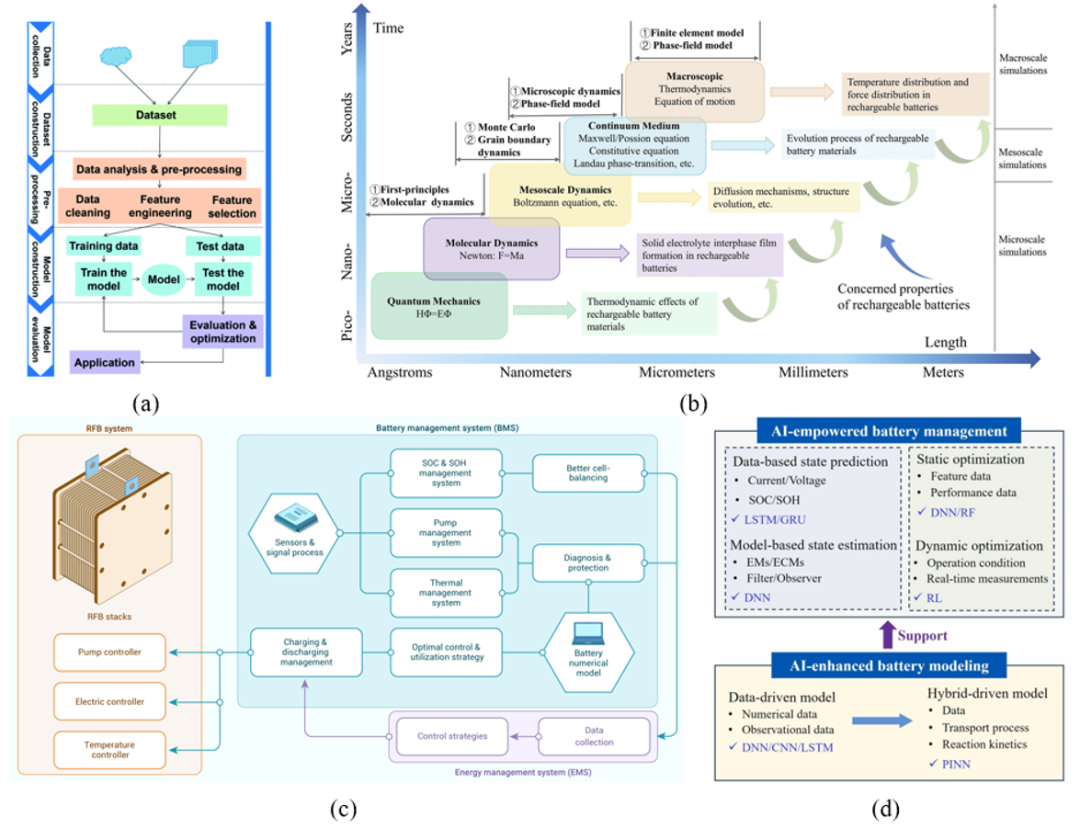
过去五年间,人工智能研究与应用进入爆发期,尤其是 2022 年底 ChatGPT 的发布,进一步展示了 AI 加速科学发现与自主实验设计的潜力。作为人工智能的核心分支,机器学习被逐步引入液流电池领域,并极大推动了储能系统的发展。早期研究主要聚焦于搭建总体框架与展望未来:2022 年,Li 等[8]首次系统总结了机器学习应用于氧化还原液流电池的核心工作流程(图1a),重点讨论了先进数据算法在加速有机液流电池活性分子高通量筛选(电位、溶解度、稳定性等性质)、电极结构与隔膜优化、钒液流电池系统性能预测中的关键作用,并前瞻性地指出了数据质量、多源数据偏倚与模型可解释性等基础性挑战。这一开创性工作虽建立了机器学习在液流电池中的一般范式,但当时研究深度有限,多局限于单一环节或单一部件的初步预测,贯通材料—硬件—系统的系统性框架尚未形成。
进入 2024 年,相关研究向材料发现、硬件创新与系统管理三个方向并行深入推进。在材料领域,Tang 等[9]阐述了高通量计算筛选与机器学习在液流电池材料开发中的深度融合(图1b),展示了量子机器学习、强化学习与各类生成式模型如何在微观、介观、宏观多尺度上实现材料的快速发现与优化,强调 DFT 计算、分子动力学模拟与实验数据的多源协同。在硬件领域,Pan 等[10]聚焦大容量储能电堆创新,分析了电解液、流场、电极与膜组件的最新设计进展,讨论了电堆内部电流分布不均与热管理等工程挑战,并提出面向大容量液流电池系统的集成优化方案(图1c)。与此同时,Zhu 等[11]针对以往研究“重材料、轻系统”的不足,在单电池、电堆与系统三个层级对液流电池进行了分层综述,重点总结了运行参数监测、状态估计算法以及热/水管理策略,旨在通过优化电池管理系统(BMS)提升液流电池的运行稳定性与服役寿命。
2025 年以来,研究范式进一步从孤立应用走向自适应建模与全系统集成。Zheng 等[12]阐明了从传统数值建模向自适应 AI 建模转变的必然性,系统展望了 AI 赋能液流电池建模与管理的全景(图1d),重点讨论了 AI 在实时动态状态估计与自适应管理策略中的应用,并批判性地分析了 AI 模型在复杂实际工况下的鲁棒性。Yadav 等[13]进一步将研究范围拓展至微电网场景,系统阐述了人工智能、数字孪生与物联网(IoT)的集成机制,不仅探讨了这些前沿技术在提升液流电池能量管理系统(EMS)效率中的重要作用,还强调了其在电网级功率响应、故障诊断与网络安全防护中的应用潜力。
尽管已有综述从不同角度对氧化还原液流电池进行了较为全面的综述,但专门面向水系液流电池(ARFBs)全生命周期研究的工作仍然较少。此外,当前机器学习文献在不同电池化学体系间分布并不均衡:分子性质预测、材料筛选与电解液设计的研究主要集中于水系有机液流电池(AORFBs),而钒基、铁基液流电池的相关工作则更多集中在电极、流场与系统级优化。有鉴于此,本综述系统梳理了机器学习在水系液流电池中的最新进展,覆盖材料发现、膜/电极/流场等硬件优化、电池状态估计与系统管理四大板块,并重点突出了机器学习在应对水系本征瓶颈(pH-电位耦合、溶解度—电位权衡、副反应抑制)中的核心驱动作用。
一、活性材料与电解液:从高精度性质预测到闭环智能研发
在水系液流电池的材料开发中,电解液活性分子的多维物理化学性质直接决定系统的能量密度与稳定性。传统实验试错与量子化学计算普遍存在成本高、周期长的问题。作为新兴的数据驱动技术,机器学习凭借强大的非线性拟合与跨尺度特征映射能力,已成为加速电解液分子性质高精度预测的关键工具。
(1)高精度性质预测。为从浩瀚化学空间中快速筛选候选分子,研究者首先建立了面向核心电化学性能的精准预测模型。Sorkun 等[14]开发了名为 RedPred 的机器学习模型,通过提取复杂的分子拓扑描述符并采用集成学习算法,实现了对大量水系有机电解液氧化还原电位的超快评估,均方根误差(RMSE)仅为 0.07 V。然而,传统隐式溶剂模型在处理复杂支持电解质环境时面临参数化困难。为克服单一黑箱模型在跨尺度物理量预测中的局限,Wang 等[15]进一步开发了 MLP-MLMD 框架,将机器学习势函数(MLP)与分子动力学相耦合,结合高精度神经网络势函数与自由能采样,使有机分子标准热力学势的预测精度可与全量子化学计算相媲美,并实现了对水溶液体系中酸解离常数(pKa)的高精度定量计算。
除分子本征电化学性质外,电解液的热物理流变性质对系统实际运行同样关键。Kanti 等[16]采用可解释集成学习算法最小二乘提升树(LSBoost),分别预测了钒液流电池中氧化石墨烯/MXene 杂化纳米流体的热导率、电导率与黏度,并借助 SHAP 值进一步揭示了温度与纳米颗粒浓度对流变行为的非线性影响规律。主流预测模型的系统对比详见原文 Table 1。
值得注意的是,面向水系液流电池系统的高精度预测远不止上述常规性质,更需要攻克水系体系特有的复杂机制。实验数据稀缺、本征水合效应以及强烈的 pH-电位耦合敏感性,是活性分子在实际运行中发生降解的根本原因。为弥合计算与实验之间的鸿沟,Gao 等[17]构建了一个涵盖实际 pH 值与实验测量数据的有机液流电池综合数据库,并在此基础上开发了轻量级图机器学习(Graph ML)模型。该模型通过精准捕捉共轭结构与氢键位点,实现了对实验电位与计算电位的双向高精度预测,对实验数据的 RMSE 仅为 0.091 V;通过引入环境特征,模型还能准确预测分子在不同 pH 条件下的电位移动与稳定电位窗口。该方法克服了传统理想条件下理论计算与实验后分析的局限,使研究者在材料设计阶段即可识别复杂水相环境中的化学稳定性风险。
(2)高通量筛选。高通量筛选流程的首要任务是从庞大的候选分子库中快速剔除易降解结构,因此开发具有高稳定性的新型电解液材料至关重要。Wang 等[18]采用 XGBoost 与 LightGBM 算法,对 AORFB 用醌类衍生物进行了大规模筛选,并结合理论计算识别出一系列稳定性优异的候选材料。
然而,仅凭稳定性无法满足实际需求。一种合格的水系电解液分子需要同时具备高氧化还原电位与高溶解度,而这两种性质在高通量搜索空间中通常呈现严重权衡。为破解这一瓶颈,Sorkun 等[19]进一步开发了面向水系有机电解液发现的自动化工作流 RedCat。该框架通过机器学习同时集成水溶液溶解度与氧化还原电位两个预测目标,并以溶解度作为代理指标。经过对 1.12 亿个分子的多维筛选,该工作旨在突破水系电化学窗口的限制,在控制成本的同时发现活性材料。
还需指出,仅基于理想条件下理论计算的筛选往往与电池实际性能存在较大偏差。为缩小计算预测与实际应用之间的差距,Chen 等[20]提出了一种混合评估框架,将电解液本征微观性质(如反应动力学与输运特性)映射到大型电堆的多物理场数值模拟与机器学习代理模型中,实现了在多种运行条件下对极化特性、能量效率与动态充放电行为的准确跨尺度复现与多目标优化。此外,针对水系电池在新旧化学体系切换时所面临的物理约束问题,Fu 等[21]提出了物理引导持续学习(PGCL)框架,有效避免了模型在处理不同水系材料数据集时发生的“灾难性遗忘”,使模型在迭代更新过程中对已有与新材料体系均保持可靠的评估性能。
近年来,基于机器学习的高通量筛选还逐步拓展至新兴电池体系。在氧化还原靶向液流电池(RTFB)相关研究中,He 等[22]指出,传统试错方法在匹配氧化还原介质(RM)与固态储能材料(SM)电位方面效率低下;结合 DFT 与机器学习,可快速预测蒽醌类、紫精类、TEMPO 衍生物等有机分子的氧化还原电位,拓宽了材料筛选范围,为突破水系电解液“溶解度—电位”权衡提供了新路径。
(3)智能设计与闭环研发。为应对水系液流电池化学稳定性差、能量密度低的痛点,研究者进一步探索了先进的智能研发方法论。在分子设计层面,人工智能可辅助构建精巧的保护性结构。针对碱性条件下活性物种易降解的问题,Liu 等[23]将大语言模型(LLM)与机器学习相结合,设计了具有独特“装甲状”结构的手性紫精分子。该结构可抵御强碱性环境中的亲核进攻,有效抑制研究体系中相关副反应,显著提升了分子本征稳定性。
高性能分子设计完成后,高效的实验验证与配方优化成为下一个关键环节。为最大化能量密度,Noh 等[24]采用整合机器人与主动学习的无人值守研发模式(图2)。这一闭环体系彻底革新了传统试错实验:团队仅测试了不到 10% 的候选样本,便成功筛选出溶解度超过 6.20 M 的超高浓度电解液配方,标志着液流电池研发正朝着全自动化与智能化方向演进。
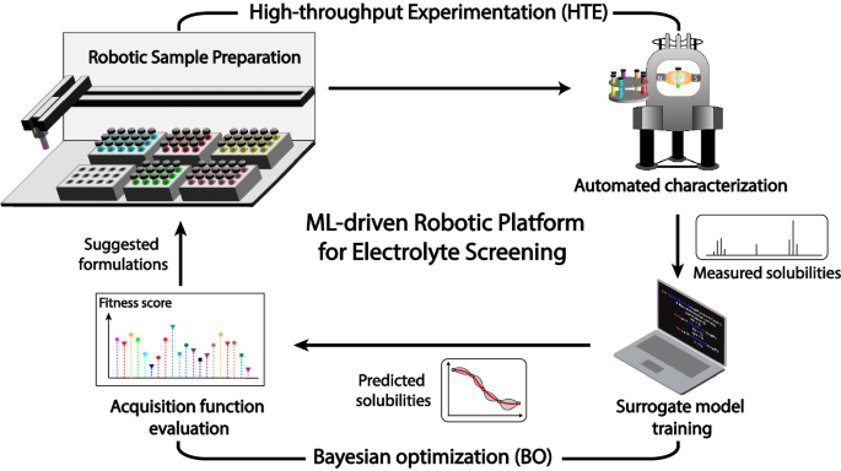
图2:基于机器学习的高通量实验平台闭环电解质筛选工作流程示意图[24]。
最后,智能研发还进一步延伸至运行中的动态监测。为实现从离线研发到动态管理的转变,Vlasov 等[25]开发了嵌入机器学习算法的混合纳米光子传感器。通过建立电解液折射率与钒离子浓度之间的非线性关联,该系统实现了钒液流电池的实时在线 SOC 监测。这种智能传感为构建自主电解液研发体系提供了数据支撑,并保障了电池在复杂实际条件下的长期可靠运行。
(4)批判性分析。尽管机器学习在电解液分子筛选中展现出极高效率,但不容忽视的是,当前超过 80% 的研究数据集来自 DFT 计算而非真实实验数据。这种以计算数据训练模型去预测计算结果的范式存在显著潜在风险:尤其是对水系液流电池,传统 DFT 计算普遍采用隐式溶剂模型,极大低估了真实水溶液中复杂氢键网络、溶剂化效应以及局部 pH 的动态变化。其后果是,许多被 ML 模型预测为高溶解度、高稳定性的分子,在实际合成与电池测试后迅速因水解、聚合等副反应而降解。未来亟需建立实验—计算双驱动数据集,并引入主动学习策略,以少量关键实验数据动态校正机器学习模型的预测误差。
二、关键硬件优化:膜、电极与流场
前述工作聚焦材料层面电解液分子的本征物理化学性质,但优异的材料并不足以单独决定水系液流电池的最终性能——承载反应的硬件系统同样关键。在 ARFB 设计框架中,膜的离子选择特性、电极的电催化活性以及流场的传质效率共同决定了系统整体表现。然而,电极微观拓扑与宏观流场几何参数之间存在复杂的多物理场耦合机制,传统经验设计与纯 CFD 模拟普遍面临计算成本高、优化空间有限的问题。近年来,机器学习已提供了覆盖局部微观至全局宏观的跨尺度解决方案。
(1)机器学习辅助的膜设计与性能优化。膜材料的离子选择性、离子传输行为与溶胀特性直接影响液流电池的长期运行性能,因此传统膜设计通常需要在活性物种阻隔与离子传导之间协同优化。例如,Li 等[27]通过将 PVDF 与 Ketjen 黑复合入 Nafion 中,构建了电荷增强型离子选择性膜:膜内固有负电荷可排斥多硫化物与聚碘化物,而 PVDF 的疏水性则降低了吸水率与膜溶胀,从而有效抑制活性物质交叉与水迁移。这一工作表明,材料组成与膜结构的协同设计可显著提升膜的选择性与稳定性。
然而,传统方法往往依赖对多种材料组合与结构参数的分步实验筛选,当材料组成、制备条件与结构参数复杂度上升时,经验试错在高维参数空间中的效率十分有限。为此,机器学习被逐步引入膜材料设计与性能优化:针对 Zn/MnO₂ 液流电池,Wei 等[28]采用梯度提升决策树(GBDT)分析聚合物官能团与 Zn²⁺/H⁺ 离子电导率之间的关联,并在模型预测指导下设计了交联磺化聚合物膜,实现了通过机器学习对膜材料组成的反向筛选。Li 等[29]进一步将机器学习拓展至膜制备工艺优化,通过建立溶剂性质—膜形貌—电池性能之间的关联,筛选并优化了多孔 PBI 膜的溶剂处理流程,并结合 DFT 计算解释了聚合物—溶剂相互作用对膜结构形成的影响机制。
随着数据驱动方法与膜微观结构调控的进一步融合,机器学习已被用于制备参数优化、微观结构调控与性能预测:Zhang 等[30]利用多层感知机(MLP)建立了溶液浓度、FGO 负载量、旋涂转速与膜性能之间的映射关系,实现了制备参数的定量优化,为膜微观结构调控提供了指导;Çolak 等[31]则采用人工神经网络(ANN)与 XGBoost 预测改性 SPEEK 膜在 VRFB 中的性能,从已有实验数据集中构建了膜组成、钒离子浓度与电化学性能之间的非线性关联。近年,Mu 等[32]进一步结合大语言模型的文献知识筛选潜在交联剂,辅助设计了用于碱性锌铁液流电池的抗溶胀杂化双网络膜,将机器学习的应用从“基于实验数据的预测”推向“知识驱动的材料设计”。总体而言,液流电池膜研究正从材料组成筛选、制备参数优化走向微观结构调控、性能预测与知识驱动设计,但仍受限于数据量有限、数据一致性不足以及跨材料体系泛化能力差等问题。
(2)电极微观拓扑构建与表面活性调控。电极是电化学反应的核心场所,其性能取决于由微观拓扑与表面催化效率共同决定的传质能力。与非水系体系相比,水系液流电池多孔电极设计面临独特挑战:提升活性往往会在特定过电位下触发水分解副反应(析氢、析氧),而强酸、强碱或高盐电解液又对电极长期化学稳定性提出严格要求。为此,机器学习在电极设计中提供了两条互补路径:物理骨架的空间拓扑优化与界面化学的功能调控。
在物理骨架优化方面,核心目标是构建能够实现快速反应与低电阻的电极拓扑结构。Wan 等[33]将机器学习与遗传算法(GA)深度融合,在 2275 组具有不同纤维特征的多孔结构上训练后,建立了结构—性能关联图谱(图3a),准确预测了电极极化,并揭示直径约 5 μm 的对齐纤维是提升性能的关键。Berkowitz 等[34]则采用基于数字孪生思想的高保真代理模型,利用随机森林(RF)算法仅用少量高质量实验数据即精确刻画了碳布电极的微观特征,为极化降低提供了科学依据。
除物理骨架优化外,机器学习在提升电极表面电催化活性与界面稳定性方面亦展现出巨大潜力。针对水性有机电解液强腐蚀性导致界面催化剂易降解失活的问题,Liu 等[35]应用机器学习算法筛选并稳定了具有优异催化性能的不对称氧化镍(Ni⁴⁺),并通过 ML 引导的薄膜合成修饰电极,显著提升了电压效率。在界面工程方面,Lin 等[36]发现水相多硫化物液流电池中界面传质受限,通过引入 EMP⁺ 屏蔽电极表面局部负电荷,将还原速率提升了两个数量级;该研究虽未直接使用机器学习,却为未来在电极界面优化模型中引入双电层效应提供了机理启示。Berkowitz 等[34]进一步利用机器学习指导多孔胶黏涂层设计,通过优化碳布电极上涂层形貌,有效增大了与活性物种的接触面积并降低了界面阻抗。
(3)流场设计的统计规律挖掘与参数优化。在完成电极微观环境优化之后,宏观流场的几何设计直接决定电解液在电极反应区域的分配均匀性。传统流场设计高度依赖昂贵的 CFD 模拟,且大多局限于对特定构型的试错探索。为克服这一缺陷,研究者将机器学习引入优化,旨在从复杂流体数据中直接提取设计规律。
在铁铬、全钒等典型水系液流电池的工业放大过程中,电解液通常需在高流量下运行以实现高功率输出,这就在强化内部传质与增大泵送损失之间形成了严苛权衡。针对这一独特优化难题,Zhou 等[37]以随机森林算法建立了铁铬液流电池中互指流道的流体—电化学耦合代理模型,阐明了流道间距、流量与电流密度之间的内在关联(图3b),并通过数据驱动策略识别出使泵送损失最小化同时保持良好传质性能的最优间距。
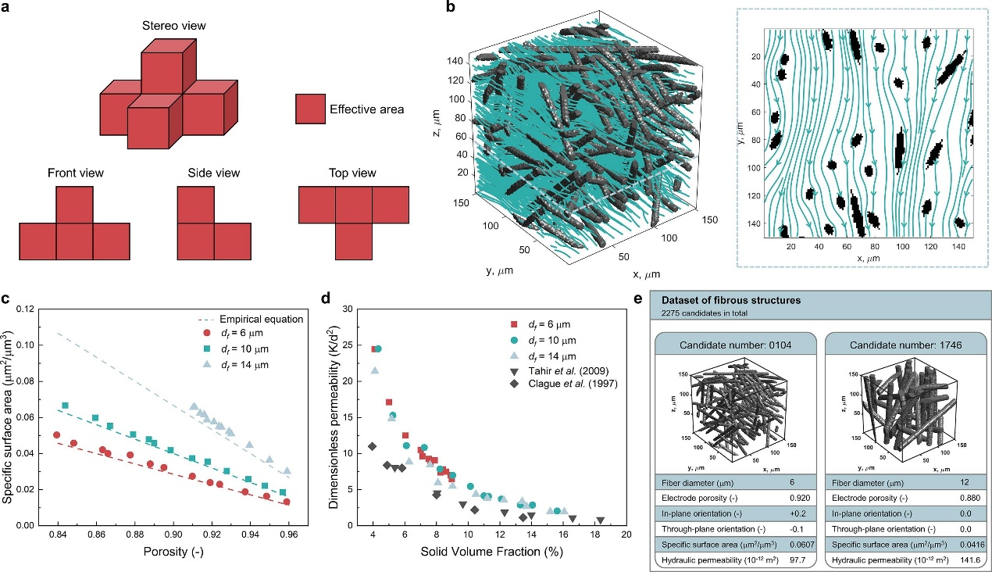
(a)
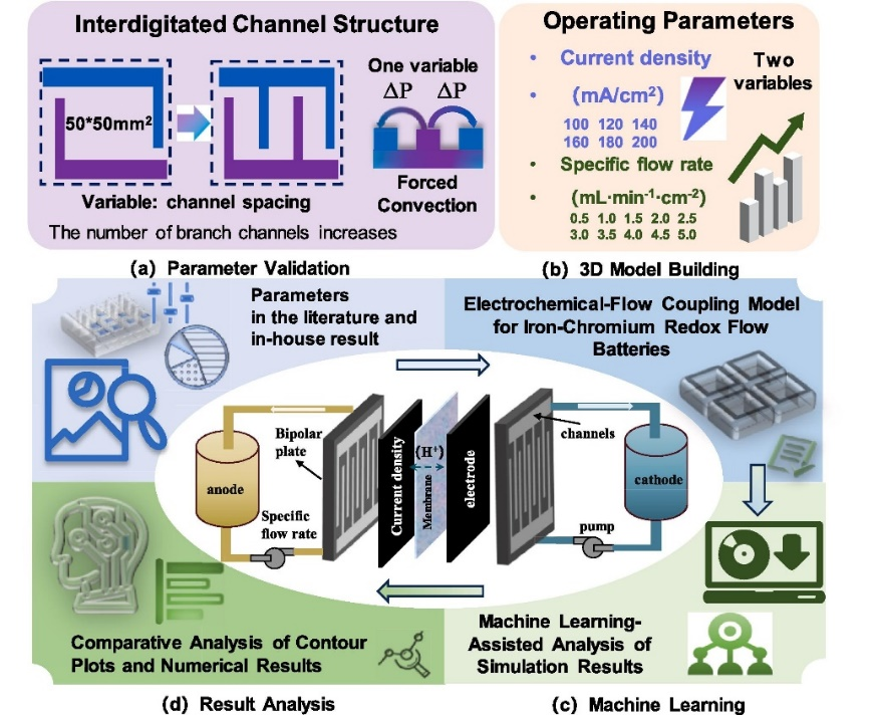
(b)
图3:机器学习驱动的液流电池核心部件(电极与流场)拓扑优化概览。(a) 多孔电极微观形貌与孔结构的ML驱动拓扑优化[33];(b) 宏观双极板流场的流道结构与流体动力学重构[37]。
然而,针对单一构型发展出的优化方案难以推广到其他流场体系。为克服案例特异性局限并建立通用设计准则,Yu 等[38]提出了一个可适应多种流场构型的通用统计框架,通过分析涵盖不同拓扑结构的 110 组仿真数据,厘清了纵向与横向流路之间的权衡,并实现了对新设计流道几何的通用性能预测。
(4)快速建模与在线监测。上述基于统计规则的代理模型虽提升了特定参数的预测效率,但本质上是对离散值进行低维映射,无法重构电极内部连续、高维的多物理场等值线。为解决传统模拟中计算成本与精度之间的矛盾,深度学习正在重塑液流电池的仿真范式。当前,基于计算机视觉架构的深度学习工具(如 U-Net)已能实现从几何构型到流场等值线的端到端超快模拟[39]。与依赖迭代求解物理方程的传统 CFD 软件不同,神经网络模型可在毫秒级时间内生成准确的电解液分布云图,计算成本降低超过 99.9%。这种近实时仿真能力大大缩短了设计周期,为构建水系液流电池全生命周期数字孪生系统奠定了算法基础。原文 Table 2 系统总结了机器学习在膜、电极与流场等关键硬件组件中的代表性应用。
(5)批判性分析。在部件优化层面,现有基于卷积神经网络或代理模型的工作主要聚焦于膜性质、电极微观结构与流场特征的预测优化,以及单物理场的快速近似。然而,液流电池的实际运行是一个涉及传质、电荷传递与流体动力学高度耦合的动态过程,当前模型在从微孔结构向全尺度宏观电极与流场跨尺度泛化时精度严重下降;多数模型采用较为理想化的运行与边界条件,未充分考虑长期运行中的膜溶胀与降解、电极局部老化以及流场随机扰动。与电极和流场中相对成熟的应用相比,机器学习辅助膜设计仍处于早期阶段,覆盖膜组成、制备、微观结构与长期稳定性的研究十分有限。未来突破方向在于深度融合物理信息神经网络(PINN):将 Navier-Stokes 方程与电化学动力学方程(如 Butler-Volmer 方程)的残差作为正则项显式嵌入损失函数,在最小化标注数据预测误差的同时惩罚违背动量守恒与反应动力学的物理残差,从而显著降低模型对“理想化训练集”的依赖,提升跨尺度预测的物理合理性与鲁棒性。
三、电池状态监测与系统管理:从底层传感至高层健康评估
前述内容聚焦材料与硬件设计,但即便完成优化的设计阶段,水系液流电池仍无法单凭设计保证长期可靠运行。打通“设计优化”与“实际运行”之间的鸿沟,依赖于对电池内部状态进行实时监测与调控的能力,这正是本部分关注的焦点。水系液流电池系统的稳定运行与长寿命,本质上依赖于对内部状态的实时、准确监测与调控。然而,这类电池具有高度非线性的化学动力学,并同时受电解液交叉污染、泵送流量波动与环境温度变化等多重因素影响;传统基于开路电压(OCV)或安时积分的监测方法在复杂动态工况下误差累积大、鲁棒性差。近年来,机器学习凭借强大的特征提取与非线性映射能力,已从底层传感器优化、中层状态估计与高层健康管理三个维度全面革新液流电池的智能管理系统。
(1)底层传感器优化。获取高质量的基础运行数据是实现准确系统管理的前提。水系液流电池在强酸或强碱性腐蚀条件下运行,会引起传感器信号漂移;电解液交叉污染亦会导致组成偏离。Vlasov 等[25]提出将纳米光子—微流控传感器与机器学习相结合(图4),通过捕捉电解液折射率的细微波动并采用 LightGBM 算法进行信号解耦,实现了电解液浓度的原位实时监测。这种硬件传感与算法补偿相结合的模式,有效提升了物理传感器在苛刻水相环境中的鲁棒性,为动态追踪活性物种提供了数据支撑。
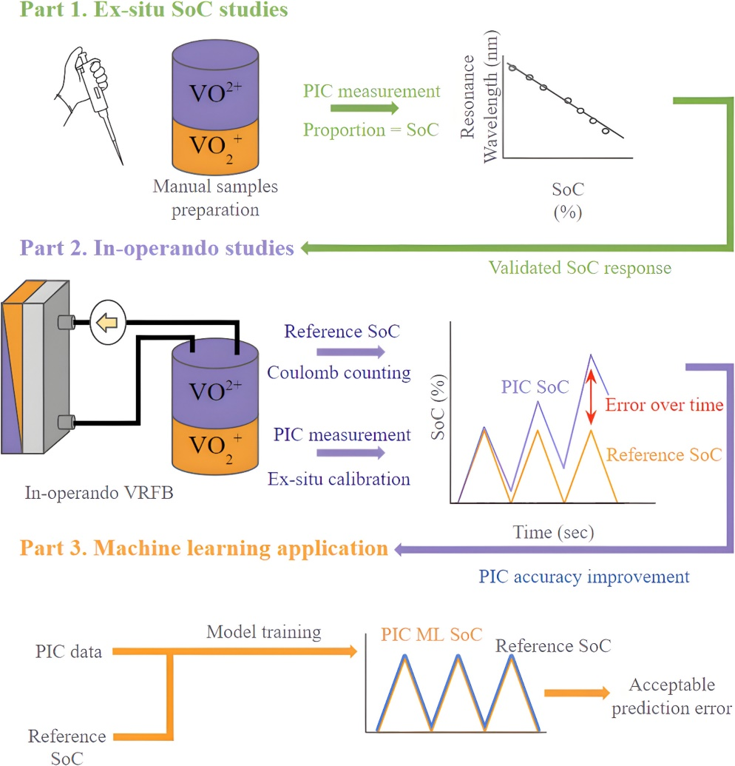
图4:基于纳米光子微流控传感器与机器学习的VRFB荷电状态监测研究框架[25]。
(2)中层状态估计。在获得多维传感数据之后,实时电池状态监测的核心在于应对水系电解液高度非线性的化学动力学,并在变工况下维持 SOC 的高精度预测。针对工业应用中频繁出现的流量波动问题,Li 等[40]开发了融合卷积神经网络(CNN)与门控循环单元(GRU)的混合深度学习框架(图5a):CNN 提取电流、电压与流量之间的空间耦合特征,GRU 捕捉 SOC 随时间演化的长期依赖,使模型在多种流量条件下均显著优于传统算法(RMSE = 2.79%,MAE = 2.28%,R² = 98.52%)。为进一步提升算法在大规模实际系统中的可靠性,Zheng 等[41]采用循环平衡网络(REN),通过直接参数化保证模型的稳定性与收敛性(MAE = 0.97%,RMSE = 1.21%)。此外,物理信息深度学习已成为重要研究趋势:Clemente 等[42]利用神经网络建模水系电池复杂过电位,并将模型嵌入传统电化学观测器,这种数据—物理融合范式既保留了深度学习的强拟合能力,又确保状态估计严格遵循水系电池的基本物理定律(相对误差 < 5%)。
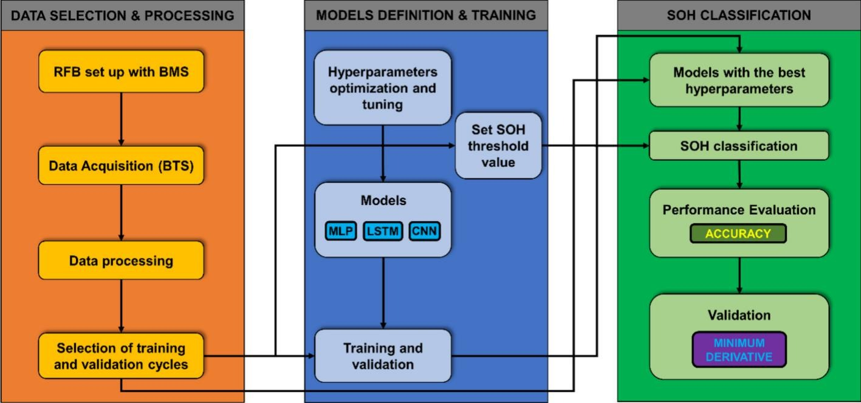
(3)高层健康管理。当电池进入运行中后期,系统管理的重心从实时监测转向长期健康评估。通过机器学习算法对 SOH 进行智能分类,对于故障预防与延寿至关重要。与 SOC 预测更多依赖长期演化趋势不同,SOH 预测关注充电电压特征的变化。Cantera 等[43]以充电电压导数为核心特征(图5b),对比 MLP、LSTM、CNN 等多种模型,实现了电池退化程度的准确分类(准确率 93%–100%),可在不解体电池的情况下原位识别容量衰减机制,为系统早期预警与运维提供了可靠的理论指导。原文 Table 3 对代表性状态估计算法进行了横向对比。
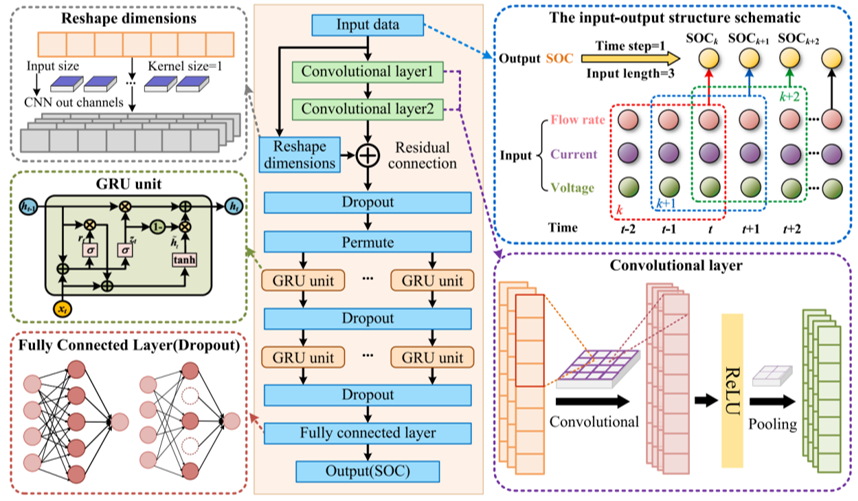
(a)
(b)
图5:液流电池SOC与SOH估计的典型深度学习算法框架。(a) 面向变流量工况的CNN-GRU混合架构[40];(b) 基于充电电压一阶导数的SOH分类工作流[43]。
(4)批判性分析。在系统管理层面,LSTM、GRU 等算法在 SOC/SOH 在线估计中已取得令人满意的拟合精度,但这些模型的训练数据几乎全部来自实验室理想条件下的恒流恒压(CC-CV)充放电测试。在实际电网储能场景中,液流电池面临不规则高频功率波动、长期不完整充放电循环与剧烈环境温度变化,由于缺乏工业运行数据用于训练,现有模型在真实工况部署时往往出现严重的泛化失效。此外,交叉污染与电解液失衡作为水系液流电池长期运行的本征问题,在当前 SOC/SOH 估计模型中被普遍忽略。 poor transferability 仍是关键障碍:基于单电池、固定化学体系、受控 CC-CV 条件训练的模型,在面对非均匀流场、温度分布、旁路电流、膜交叉、电解液失衡、气体析出、电极压缩、接触电阻与长期老化等实际电堆工况时,其输入—输出映射会发生漂移。跨化学体系(全钒→铁铬→有机→靶向体系)、跨电池设计与跨尺度迁移,则因氧化还原动力学、溶剂化结构、衰减路径与主导输运机制的差异而更加复杂。因此,未来亟需发展具备迁移学习能力、可在线自适应不规则输入的时间序列模型,并结合在线参数辨识,才能真正落地到兆瓦级储能电站的 BMS 中。
四、多物理场代理建模与数字孪生
随着水系液流电池研究向智能化方向推进,传统机理模型在计算效率与实时状态感知方面的局限日益突出。为突破这一瓶颈,研究者引入机器学习算法构建高精度代理模型,并进一步集成至数字孪生(digital twin, DT)系统之中。
(1)驱动数字孪生的高精度代理模型。高精度代理模型是数字孪生实现快速仿真与决策的核心引擎。针对液流电池复杂的流体—电化学耦合特征,研究者面向不同尺度对象发展了多层次通用求解策略。在全局系统层面,物理约束与数据驱动的深度融合有效解决了复杂非线性方程的收敛难题,显著提升了极端工况下全电池模型的预测鲁棒性。He 等[44,45]提出并优化了物理约束深度神经网络(PCDNN),通过将电化学方程嵌入损失函数,实现了 VRFB 关键参数的准确学习;Clemente 等[42]将深度学习与传统观测器相结合,采用神经网络建模电池过电位,在降低模型复杂度的同时提升了 SOC 估计精度;针对时间序列数据,Li 等[46,47]采用 1D-CNN 与 2D-CNN 架构,在无需专业电化学知识的前提下实现了端电压的快速预测。
其次,图像驱动的代理模型具备很高的计算效率,可快速重构电解液流动与参数分布。Guo 等[39]基于 U-Net 架构建立了流场图像代理模型,可在数秒内完成电解液分布仿真并准确识别电极内部死区。在微观尺度,Luo 等[48]提出了融合孔网络与神经网络的多尺度模型;Lin 等[49]则基于符号距离场(SDF)开发了 Electrode Net,实现了微观输运性质的超快跨尺度预测(图6)。最后,基于统计学习的回归模型在结构参数敏感性分析方面表现出色:Berkowitz 等[34]采用随机森林与梯度提升回归构建高保真代理模型,揭示了碳布电极微观结构对极化的影响;Zhou 等[37]采用随机森林阐明了铁铬液流电池中流道间距与传质之间的耦合机制。这些高效模型为后续结构优化(如 Chu 等[50]通过萤火虫算法优化 BP 网络)奠定了坚实基础。
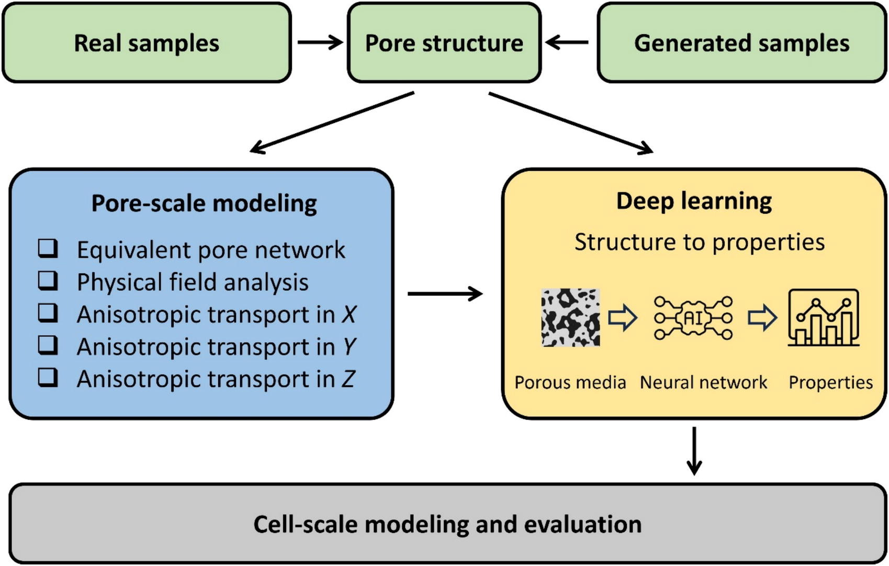
图6:Electrode Net 多孔电极多尺度代理模型框架[49]。
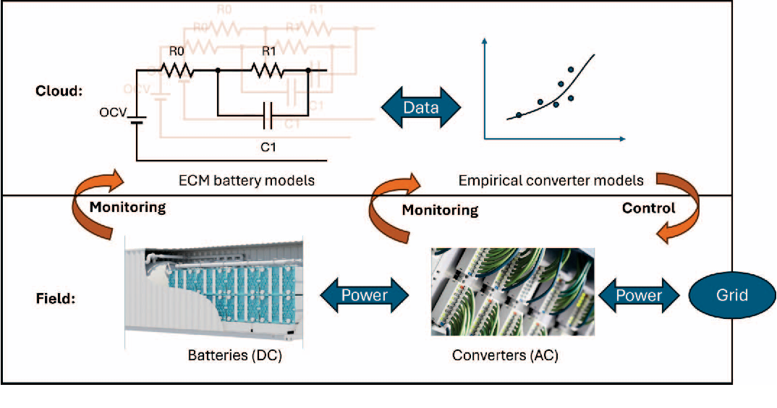
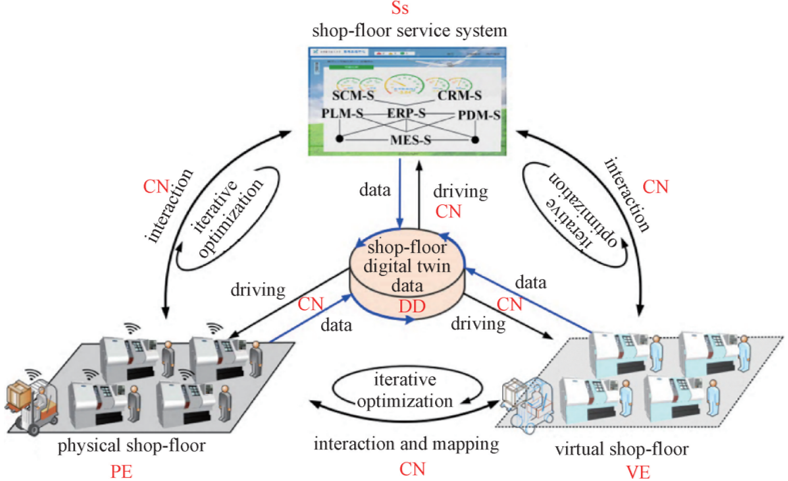
(2)数字孪生系统的集成与应用。在上述高精度代理模型基础上,数字孪生进一步融合实时传感数据与仿真算法,实现水系液流电池全生命周期的虚实映射。在系统运维层面,数字孪生支持电网级实时监测。Zhao 等[51]将数字孪生技术应用于一套 75 kW/500 kWh 全铁液流电池系统,通过结合等效电路模型与功率变换器实测数据,实现了系统运行状态的在线映射(图7a)。Wang 与 Sang[52]在综述中指出,数字孪生将成为液流电池智能管理与运行效率提升的核心路径,并强调了五维数字孪生(5D DT)架构不可或缺的作用(图7b):该架构由物理实体(PE)、虚拟实体(VE)、服务系统(Ss)、数字孪生数据(DD)与连接(CN)五个核心组件构成,实现物理电池系统与数字副本之间的双向实时交互与迭代优化。
(a)
(b)
图7:面向储能的数字孪生。(a) 集成现场监测的ECM电池模型与经验变换器模型框架[51];(b) 五维(5D)数字孪生参考架构[52]。
在精细化管理层面,数字孪生可实现原位故障诊断与长期性能预测。Cantera 等[43]以充电电压导数为特征信号,在数字孪生平台上集成多种神经网络架构,实现了电池容量衰减机制的原位诊断而无需拆解电池;Emanuel 与 Rycroft[53]构建了电极的三维数字孪生,从基本物理机理出发,为电极几何结构的定量评估与实时数字监测提供了高保真支撑。
(3)数据集构建、质量与标准化。机器学习模型对 ARFBs 的可靠性不仅取决于算法选择,更取决于训练数据的质量、一致性与代表性。相关数据可来源于已发表文献与补充材料、实验测量以及计算研究。实验数据提供理化性质、电化学性能与运行参数;DFT、CFD 与其他数值模拟则在实验数据有限时予以补充。原文 Table 4 总结了主要数据来源、典型应用及其局限性。数据异质性仍是主要挑战:pH、电解液组成、温度、流量、电极结构、电池几何与测试协议的差异都会影响模型性能与可复现性。因此,应将相关实验与计算条件记录为元数据,采用统一单位、明确定义变量与标准化数据格式对可比数据进行 harmonization;数据清洗应处理缺失值、重复记录、不一致单位与潜在异常值,同时保留对原始来源的可追溯性。为提升模型可靠性与泛化能力,应记录数据来源、预处理流程与模型训练设置;数据集划分应避免信息泄漏,尤其当多次测量源自同一研究时;除交叉验证外,应尽可能采用独立数据集或不同运行条件进行外部验证。
该综述系统梳理了机器学习在水系液流电池材料预测与筛选、部件结构拓扑优化、多物理场代理建模、在线状态估计与数字孪生实现等关键方向的最新进展与发展趋势,主要结论可概括如下:
其一,在活性物质与电解液研发方面,一个由基础预测工具、高通量实际部署与面向复杂体系靶向优化组成的渐进式研究范式已然形成。机器学习在加速活性材料发现(尤其是水系有机液流体系)方面展现出巨大潜力,并在物理引导与智能闭环工作流的加持下,从根本上变革了液流电池材料开发的底层逻辑。
其二,在电极与流场等核心部件优化方面,机器学习在处理复杂耦合多物理场问题上表现出卓越能力:从微尺度电极拓扑的精确设计、宏观流场通用规律的统计分析,到深度学习驱动的超快速仿真,这些技术大大缩短了研发周期,为高性能、低能耗水系液流电池提供了从微观设计到系统级优化的综合解决方案。